서버가 내 브라우저를 조종해 데이터를 수집한다고? 오픈소스 ArachneControl 살펴보기
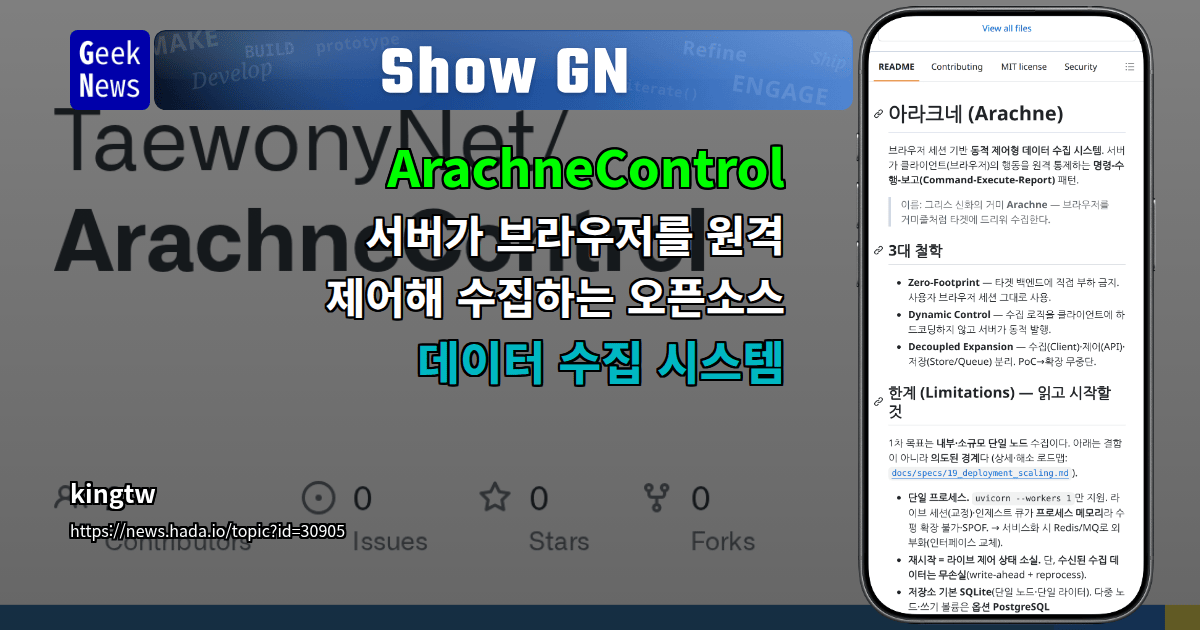
한눈에 보는 요약
웹 크롤러를 한 번이라도 만들어 본 분이라면 공감할 겁니다. 타겟 서버에 요청을 보내다 차단당하고, 로그인 벽에 막히고, 수집 로직이 바뀔 때마다 클라이언트를 다시 배포하느라 진땀을 뺍니다. ArachneControl은 바로 이 세 가지 고질병을 설계 단계에서 풀어버린 오픈소스 self-hosted 데이터 수집 시스템입니다.
핵심 아이디어는 한 문장으로 정리됩니다. "서버가 사용자의 실제 브라우저를 원격으로 조종해 수집한다" — 이른바 명령–수행–보고(Command-Execute-Report) 패턴입니다.
어떻게 동작하나요?
일반적인 크롤러는 서버가 직접 타겟 사이트에 요청을 쏩니다. 그래서 부하·차단·로그인 문제가 생기죠. ArachneControl은 발상을 뒤집습니다.
- 수집은 이미 로그인되어 있는 사용자의 실제 브라우저가 대신 수행하고
- 무엇을, 어떻게 수집할지는 서버가 런타임에 동적으로 명령을 발행합니다.
즉 클라이언트(브라우저)는 "손과 발", 서버는 "두뇌" 역할을 맡는 구조입니다.
눈에 띄는 특징들
1. Zero-Footprint — 흔적을 남기지 않는 수집
타겟 서버에 직접 요청하지 않습니다. 이미 로그인된 사용자의 브라우저가 사람과 똑같이 접근하기 때문에, 로그인 벽 안쪽 데이터도 자연스럽게 다룰 수 있고 백엔드 부하나 차단도 피해 갑니다.
2. 서버가 실시간으로 제어
브라우저에 심는 북마크릿은 한 번 등록하면 영구 불변입니다. 정작 바뀌는 수집 규칙(셀렉터·액션·추출)은 서버가 타입 커맨드로 발행하죠. 덕분에 로직을 바꿔도 클라이언트 재배포가 0회입니다. 단일 소스인 Pydantic 모델에서 TypeScript 타입을 자동 생성해 서버와 클라이언트의 타입 불일치도 막습니다.
3. 클릭만으로 수집 레시피 작성
WebUI에서 원하는 요소를 클릭하면 셀렉터가 자동 생성됩니다. click·drag·scroll·swipe 같은 액션 시퀀스를 엮어 extract 레시피로 저장하면 끝. 코드를 손으로 짜지 않아도 됩니다.
4. 무손실 적재와 자동 복구
write-ahead 방식으로 동기 커밋 후 202를 반환하고, 멱등성을 보장하며, 재시작 시 자동으로 복구합니다. 수집 도중 죽어도 데이터가 새지 않도록 설계했습니다.
5. MCP 에이전트 연동
라이브 파이프를 MCP 도구로 노출해 AI 에이전트가 활용할 수 있습니다. 다만 host allowlist·rate-limit·op TTL 같은 가드가 걸려 있습니다.
보안은 기본 ON
눈여겨볼 점은 secure-by-default 철학입니다.
- 관리 인증이 기본 활성화(Jupyter처럼 자동 토큰 발급)
- 서버 응답의
eval실행과 외부 비콘에 명확한 실행 경계 설정, eval은 화이트리스트 기반 - 핑거프린팅 미사용
그리고 제작자는 **봇 회피나 대량 스크래핑은 명시적으로 비목표(non-goal)**라고 못 박았습니다. 무분별한 크롤링 도구가 아니라, 본인이 접근 권한을 가진 데이터를 안전하게 다루기 위한 도구라는 점을 분명히 한 셈입니다.
비용 없이, 어디서나
인프라도 가볍습니다. SQLite + 인메모리 큐 + 단일 FastAPI 조합으로 외부 유료 서비스 의존이 전혀 없고, uv로 OS에 상관없이 재현됩니다. 라이선스는 MIT.
한 가지 실용 팁도 있습니다. 공개 사이트를 수집하려면 브라우저의 Private Network Access 제약 때문에 공개 URL이 필요한데, ENABLE_TUNNEL=1로 cloudflared 임시 터널을 띄워 이를 우회합니다. 실제 뉴스 사이트 수집에 성공했다는 실측 결과도 공유했습니다.
마치며
ArachneControl은 "크롤러를 또 짜야 하나"라는 피로감을 아키텍처로 해결하려는 시도라는 점에서 흥미롭습니다. 로그인 벽 안쪽 데이터를 다뤄야 하거나, 수집 로직이 자주 바뀌는 환경이라면 한 번쯤 들여다볼 만한 프로젝트입니다. 다만 강력한 만큼 "내가 권한을 가진 데이터에만" 쓰는 것이 전제라는 점은 잊지 말아야겠죠.