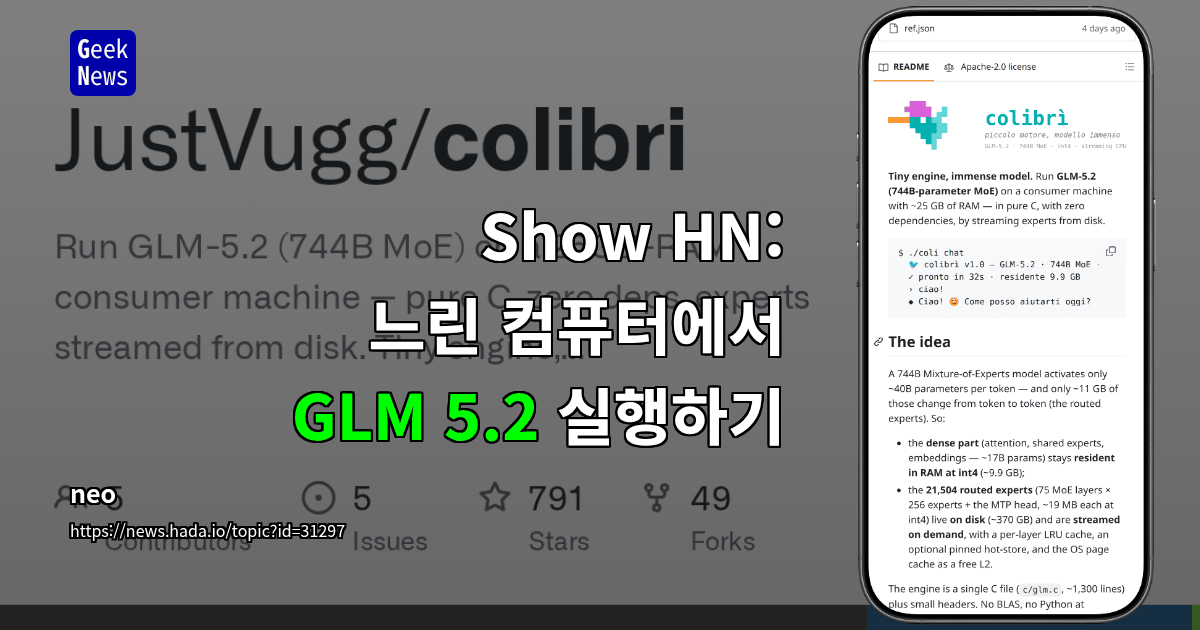
744B 초거대 모델을 25GB RAM에서? 순수 C 엔진 colibrì로 GLM-5.2 돌리기
핵심 요약
GPU도 없고 RAM도 25GB뿐인 평범한 컴퓨터에서 744B 파라미터짜리 GLM-5.2 MoE 모델을 실행한다면 믿으시겠어요? 오픈소스 프로젝트 colibrì가 바로 그 일을 해냈습니다. Python도, BLAS도, GPU도 필요 없는 순수 C 엔진(핵심 파일 약 1,300줄!)으로, 모델의 대부분을 디스크에 두고 필요한 부분만 스트리밍하는 방식이죠.
- RAM에는 dense 부분만: attention, shared expert, embedding 등 약 17B 파라미터를 int4로 양자화해 약 9.9GB만 상주
- 21,504개의 routed expert는 디스크에: 약 370GB를 NVMe에 두고 토큰마다 필요한 expert만 읽어옴
- 속도는 느리지만 '된다': 개발 환경(WSL2, 12코어, 25GB RAM) 기준 cold decode 0.05~0.1 tok/s, Apple M5 Max 128GB에서는 커뮤니티 측정 1.06 tok/s
어떻게 가능한 걸까요?
GLM-5.2는 Mixture-of-Experts(MoE) 구조라서 744B 파라미터 중 토큰당 약 40B만 활성화됩니다. colibrì는 이 특성을 극한까지 활용합니다.
- 항상 쓰이는 dense 부분(약 17B)은 int4로 압축해 RAM에 고정
- 토큰마다 바뀌는 routed expert(75개 MoE 레이어 × 256 experts, expert당 약 19MB)는 디스크에 저장
- per-layer LRU 캐시, 자주 쓰이는 expert의 pinning, OS 페이지 캐시로 디스크 읽기를 최소화
특히 재미있는 건 learning cache입니다. 실제 사용 중 라우팅된 expert 사용량을 .coli_usage 파일에 기록해두고, 다음 시작 때 가장 '핫한' expert들을 여유 RAM에 자동으로 pin합니다. 즉, 쓰면 쓸수록 빨라지는 엔진인 셈이죠.
구현 디테일도 알차다
단순한 데모 수준이 아니라 꽤 진지한 엔지니어링이 들어가 있습니다.
- MLA attention + 압축 KV-cache: 토큰당 576 floats로, 기존 대비 57배 작은 KV 캐시
- MTP speculative decoding: GLM-5.2의 multi-token-prediction head로 draft를 만들고 batched forward로 검증. int8 head 기준 acceptance 39~59%, forward당 2.2~2.8 토큰
- int8/int4/int2 양자화 커널: AVX2
maddubs기반 integer-dot 커널로 int8 matmul이 1.4~2.5배 빠름 (측정치 119 GFLOP/s) - token-exact 검증:
transformersoracle 기준 teacher-forcing 32/32, greedy generation 20/20으로 정확성 확인 - RAM 안전장치: 시작 시
MemAvailable기준으로 expert 캐시를 자동 조정해 OOM-killer를 회피
변환 과정도 배려가 돋보입니다. 오프라인 컨버터가 FP8 shard를 하나씩 받아 변환 후 삭제하는 방식이라, 756GB짜리 원본 체크포인트를 통째로 디스크에 둘 필요가 없어요. 물론 Hugging Face에 사전 변환된 int4 모델도 올라와 있어 이 단계를 건너뛸 수도 있습니다.
현실적인 기대치는?
솔직히 말하면 빠르지 않습니다. 하드웨어별 예상치(추정값)는 다음과 같습니다.
| 환경 | 예상 속도 | |---|---| | WSL2 + VHDX (~1GB/s), 25GB RAM | 0.05~0.1 tok/s | | 네이티브 Linux + PCIe4 NVMe, 32GB | 0.5~1 tok/s | | PCIe5 NVMe 또는 RAID0, 64GB + pinning | 2~4 tok/s | | 128~256GB RAM + 24~32코어 | 5~15 tok/s |
주의할 점도 있습니다. 스트리밍 자체는 read-only라 SSD 마모에 큰 영향이 없지만, RAM이 부족해 swap이 발생하면 쓰기가 생겨 드라이브를 마모시킬 수 있고, 장시간 풀 읽기 부하는 저가형 드라이브를 가열시킬 수 있으니 온도 모니터링이 필요합니다.
시작해보기
요구 사항은 Linux(또는 WSL2), AVX2 지원 CPU, 최소 16GB RAM, 그리고 int4 모델을 담을 약 370GB의 로컬 NVMe(ext4 권장)입니다.
cd c && ./setup.sh          # 빌드 + self-test
COLI_MODEL=/path/to/GLM-5.2-colibri-int4 ./coli chat
--topp 0.7(디스크 읽기 30~40% 감소), THINK=1(reasoning 활성화), DRAFT=n(MTP draft depth) 같은 옵션도 제공됩니다.
마치며
colibrì는 "초거대 모델은 데이터센터에서만 돌릴 수 있다"는 통념에 던지는 흥미로운 반례입니다. 실용 속도는 아직 멀었지만, MoE의 희소성 + 디스크 스트리밍 + 학습형 캐시라는 조합은 로컬 LLM의 가능성을 한 뼘 넓혀줍니다. NVMe가 빠르고 RAM이 넉넉한 분이라면 한번 실험해볼 만한 프로젝트네요.