토큰 다음은 '태스크'다 — AI가 사람의 암묵지를 훔쳐배우는 1조 달러 시장
한눈에 요약
ChatGPT나 Claude를 쓸 때마다 우리는 자연스럽게 '토큰'이라는 단위를 접합니다. 하지만 AI 업계 내부에서는 이제 토큰만큼, 어쩌면 그보다 더 중요한 새로운 단위가 떠오르고 있습니다. 바로 **태스크(task)**입니다. 토큰이 AI를 '얼마나 많이 쓰는지'를 보여주는 지표라면, 태스크는 AI를 '얼마나 똑똑하게 만드는지'를 보여주는 지표입니다.
토큰 경제, 우리가 익숙한 그 세계
지금까지 AI 성장을 이야기할 때 가장 많이 쓰인 단위는 추론 토큰이었습니다.
- 빅테크 기업들은 월간 처리 토큰 수를 실적 발표에 자랑스럽게 공개하고
- 분석가들은 OpenRouter 순위로 어떤 모델이 얼마나 쓰이는지 비교하고
- 경영진은 토큰 사용량 추이로 AI 투자 성과를 가늠합니다
토큰이 이렇게 사랑받는 이유는 간단합니다. 복잡한 추론 과정을 숫자 하나로 압축해주기 때문에, 기술을 몰라도 누구나 AI 생태계의 성장을 체감할 수 있거든요. AI 사용자 증가, 단순 질의응답에서 추론 모델로의 전환, 나아가 스스로 일하는 '에이전트'의 등장까지 — 이 모든 흐름이 토큰 사용량 증가로 나타납니다.
그런데 왜 갑자기 '태스크'인가?
문제는 여기서 시작됩니다. 지난 몇 년간 AI 모델은 인터넷에 있는 방대한 텍스트를 먹고 자랐습니다. 그런데 이제 두 가지 벽에 부딪혔습니다.
- 인터넷에서 새로 배울 수 있는 데이터가 바닥나고 있다
- 단순하고 범용적인 능력은 이미 포화 상태다
즉, 앞으로 모델이 더 똑똑해지려면 인터넷에는 없는 데이터, 다시 말해 **현업 전문가의 암묵지(暗默知)**가 필요해진 겁니다. 계약서를 검토하는 변호사의 판단 과정, 복잡한 재무제표를 읽는 애널리스트의 노하우 같은 것들 말이죠. 이런 지식은 구글링해서 나오지 않습니다.
이 지점에서 등장하는 개념이 바로 태스크입니다.
태스크란 정확히 무엇인가요?
강화학습 관점에서 태스크는 모델이 '연습'하는 하나의 단위입니다. 구조는 이렇습니다.
- 모델에게 초기 상태와 작업 환경을 준다 (예: 실제와 유사한 법률 데이터룸)
- 모델이 그 안에서 행동하게 한다 (예: 계약서 검토, 논거 작성)
- 그 결과를 보상 신호나 검증기로 채점한다 (예: 숙련 변호사가 만든 평가표)
- 여러 태스크의 점수를 모아 학습 신호로 삼아 모델을 더 나은 방향으로 조정한다
예전의 데이터 라벨링이 이미지에 바운딩 박스를 치거나 AI 답변에 '좋아요/싫어요'를 누르는 수준이었다면, 지금의 태스크는 훨씬 정교하고 고부가가치 작업으로 진화했습니다. 모델에게 '무엇을 해야 하는지'뿐 아니라 '어떻게 해야 하는지'까지 가르치는 셈이죠.
숫자로 보는 태스크 시장의 열기
이 시장이 얼마나 뜨거운지 몇 가지 숫자로 확인해볼까요.
- OpenAI와 Anthropic의 데이터 관련 지출은 매년 10배씩 증가하고 있습니다
- 태스크 경제 플랫폼 Mercor는 2월에 연환산매출(ARR) 10억 달러를 찍은 뒤, 불과 4개월 만에 20억 달러로 두 배가 됐습니다
- 일부 AI 애플리케이션 기업과 일반 기업들은 데이터를 경쟁 우위로 보고, 개별 태스크 관련 지출을 단기간에 1억 달러 이상으로 늘리고 있습니다
법률, 의료, 금융, 소프트웨어, 과학 등 분야마다 요구되는 데이터셋, 평가 체계, 강화학습 환경이 전부 다르기 때문에, AI 연구소는 물론 응용 서비스 기업과 일반 기업까지 뛰어드는 대규모 인프라 경쟁이 벌어지고 있습니다.
그런데 왜 잘 안 보였을까?
토큰만큼 태스크가 화제가 되지 않은 데는 두 가지 이유가 있습니다.
- 비밀주의 — 지금까지 태스크 지출은 극도로 폐쇄적인 최첨단 AI 연구소들이 주도해왔고, 이들은 데이터·태스크 전략을 거의 공개하지 않았습니다. 다만 최근 애플리케이션 기업과 일반 기업들이 '우리는 남다른 데이터를 쓴다'는 것을 마케팅 포인트로 삼기 시작하면서 조금씩 수면 위로 드러나고 있습니다.
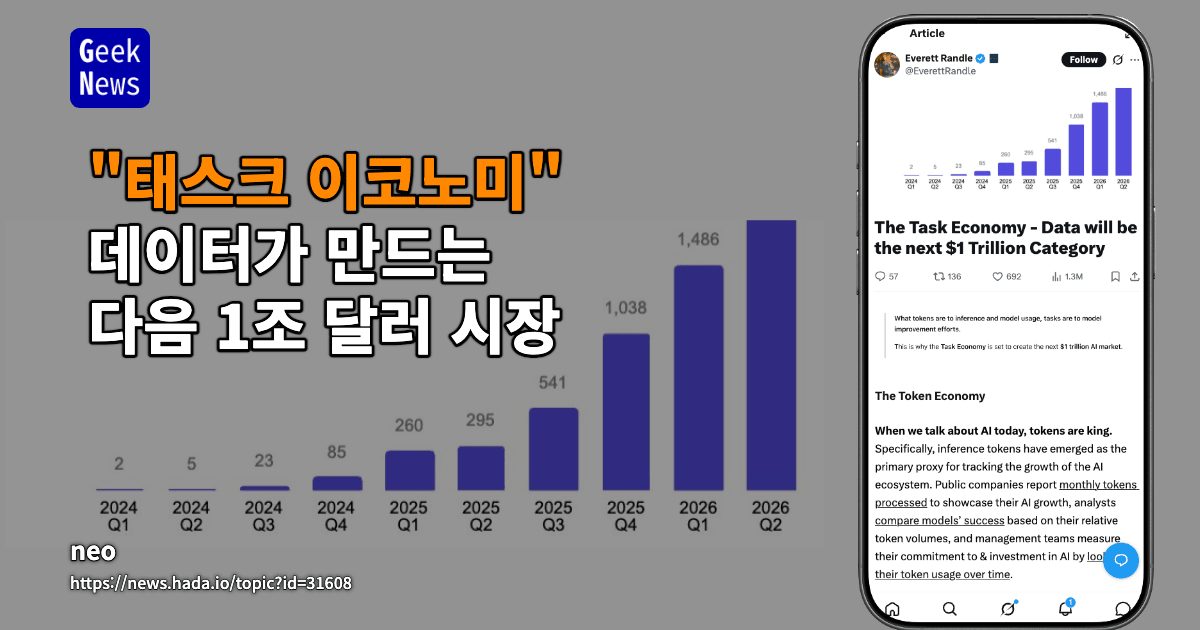
- 공통 단위의 부재 — 토큰처럼 누구나 이해할 수 있는 표준 단위가 없었습니다. 아직 '태스크판 OpenRouder' 같은, 실시간으로 시장 규모를 보여주는 서비스도 없죠. 지금은 Mercor의 분기별 전문가 작업 시간 데이터 정도가 간접적인 참고 지표로 쓰이는 정도입니다.
앞으로의 그림
결국 노트북 위에서 사람이 하는 모든 업무를 AI 에이전트가 대신하려면, 경제 전반의 모든 직종과 분야를 커버하는 태스크가 필요합니다. 법률가, 의사, 금융 전문가, 개발자, 과학자 각각의 전문 지식을 데이터로 옮기는 작업이죠.
이 글은 알고리듬 개선 같은 다른 성장 경로를 부정하려는 게 아니라, '데이터와 태스크'라는 축에 초점을 맞춘 것입니다. 인간 지식의 99%가 여전히 사람 머릿속에만 있다는 전제 아래, 이걸 어떻게 모델과 에이전트로 옮기느냐가 다음 몇 년간 AI 산업의 핵심 경쟁이 될 전망입니다. 토큰이 'AI를 얼마나 쓰는가'를 보여줬다면, 태스크는 'AI를 얼마나 똑똑하게 만드는가'를 보여주는 새로운 성장 지표로 자리 잡을 것 같습니다.