오픈 모델 Kimi K3 vs Fable 5, 뭐가 더 셀까? 정답은 '둘 다 써라'였다
핵심 요약
에이전트 작업 약 1,030건을 대상으로 오픈소스 모델 Kimi K3와 Fable 5를 정면으로 비교한 실험 결과가 흥미롭습니다. 결론부터 말하면, 어느 한쪽이 압도적으로 우월한 게 아니라 작업 성격에 맞게 두 모델을 라우팅했을 때 가장 좋은 성능과 비용 효율이 나왔다는 겁니다.
어떻게 비교했나
동일한 하네스(실행 환경)에서 두 모델에게 실제 에이전트 루프 형태의 작업을 시켰습니다.
- SWE(소프트웨어 엔지니어링): 실제 저장소 버그 수정 460개
- 터미널: 보안·암호학·리버스엔지니어링 등 장기 작업 89개
- 알고리듬: LeetCode·AtCoder 유형 100개
- 다중 언어: 6개 언어 구현 작업 225개
- 법률: 변호사가 직접 채점한 법률 에이전트 작업 120개
종합 점수는 비슷하지만, 잘하는 영역은 다르다
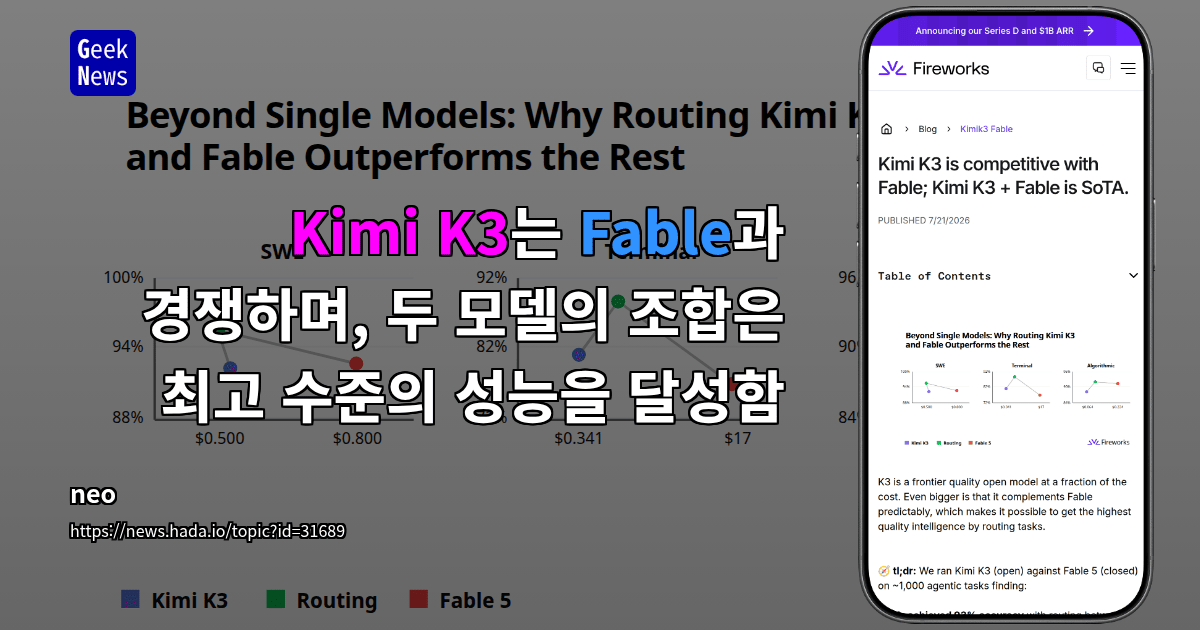
대표적으로 SWE 벤치마크에서 K3는 92.4%, Fable은 92.6%로 사실상 무승부였습니다. 하지만 세부적으로 들어가면 이야기가 달라집니다.
- K3가 강한 영역: 기호 수학, 개발 도구, 장기 터미널 작업(수십 차례 셸 조작), 법률 작업
- Fable이 강한 영역: 웹·데이터 시각화, 다중 언어 코딩 중 Java·Python·C++
특히 K3는 Fable이 풀지 못한 7z 해시 크래킹, FEAL 암호 분석, 유출된 비밀정보 탐지, 실제 취약점 발견 등 까다로운 터미널 작업을 해결해낸 점이 눈에 띕니다.
'오라클 라우팅'이 보여준 가능성
오라클 라우팅이란, 모든 모델에 작업을 시켜본 뒤 정답을 맞힌 것 중 가장 저렴한 모델을 고르는 이론적인(사후적인) 측정 방식입니다. 실제 서비스에서는 이렇게 미리 다 돌려볼 수 없지만, 이 실험을 통해 라우팅의 이론적 상한선을 알 수 있습니다.
- 오라클은 전체 작업의 72~96%를 K3에 배정했습니다.
- 그 결과 **전체 정확도는 93%**로, 개별 모델 단독 사용보다 항상 높았습니다.
- 즉 두 모델의 '중간'이 아니라 각 단일 모델을 뛰어넘는 성능을 얻은 겁니다.
비용 격차는 어디서 오나
K3의 비용 우위는 토큰 가격, 프롬프트 캐싱, 작업별 토큰 사용량이 복합적으로 작용한 결과입니다.
- SWE 작업 하나당 K3는 약 55턴·130만 토큰을 쓰고, Fable은 약 21턴·13만 토큰을 씁니다. K3가 10배 많은 토큰을 읽지만, 프롬프트 캐시 적중률 덕분에 실행 비용은 오히려 더 낮았습니다.
- 반대로 긴 터미널 작업에서는 Fable이 약 64턴·150만 토큰까지 쓰며 종종 시간 초과에 도달하기도 했습니다.
- 긴 에이전트 루프에서 K3는 Fable 단독 사용 대비 최대 약 50배 높은 비용 효율성을 보였습니다. 다만 실행 단계가 많아지는 만큼 처리 시간은 길어질 수 있어, 2초 내 응답이 필요한 작업에는 주의가 필요합니다.
그래서 어떻게 써야 할까
이 실험이 시사하는 실전 전략은 명확합니다.
- 저렴하고 빠른 오픈 모델(K3)을 기본값으로 사용하고
- 고난도·긴 꼬리 작업만 선별적으로 다른 모델(Fable)로 라우팅하는 것
이렇게 하면 단일 모델만 쓸 때보다 품질은 높이고 비용은 K3 단독 사용에 가깝게 유지할 수 있습니다. 다만 연구진은 이를 확정하려면 지금보다 10배 규모의 라우팅 데이터와 실제 환경 검증이 더 필요하다고 밝혔습니다.
결국 '최고의 AI'는 하나의 슈퍼 모델이 아니라, 서로 다른 강점을 가진 여러 모델을 워크로드에 맞게 조합하는 라우터에서 나올 가능성이 커 보입니다.