AI 에이전트가 몰래 낭비하는 토큰, CLI 하나로 잡아낼 수 있을까? — clew-custos 써봤습니다
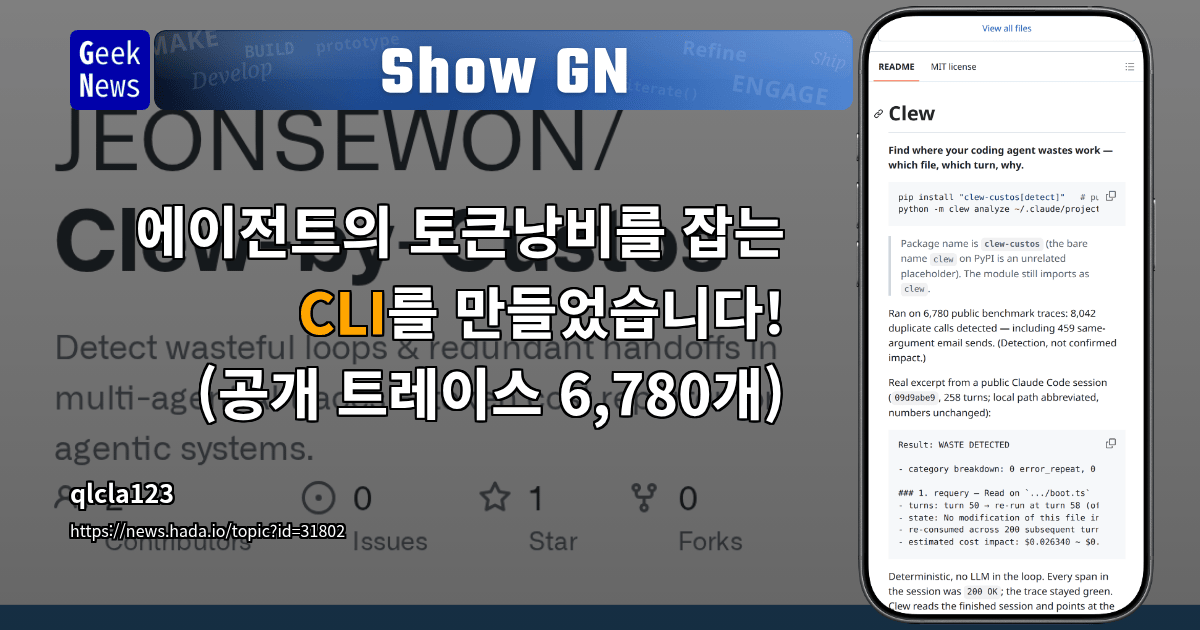
토큰 낭비, 사실은 '실패'가 아니라 '중복'이었다
Claude Code 같은 AI 코딩 에이전트를 쓰다 보면 어딘가 모르게 토큰이 술술 새는 느낌을 받을 때가 있습니다. 그런데 이 낭비의 정체는 대부분 거창한 에러가 아니라 아주 사소한 중복이었습니다.
- 같은 파일을 두 번 읽고
- 같은 인자로 도구를 재시도하고
- 이미 끝난 작업을 또 반복하는 것
이런 패턴들이 쌓이면 눈에 띄지 않게 청구서를 부풀립니다. 오늘 소개할 clew-custos는 바로 이 지점을 파고드는 오픈소스 CLI 도구입니다. 이미 끝난 에이전트 세션(트레이스)을 읽어서, "이 스텝은 앞에서 이미 한 일을 또 했다"는 지점을 콕 짚어줍니다.
어떻게 쓰나요?
설치와 실행이 아주 간단합니다.
pip install "clew-custos[detect]"
python -m clew analyze ~/.claude/projects/<slug>/<uuid>.jsonl --out report.md
- 가입도, 서버 전송도 없이 로컬에서만 동작합니다.
- 무거운
torch의존성이 없어서 설치가 몇 초 만에 끝납니다. - Python 3.12 이상이 필요하고, Claude Code 세션 파일은 보통
~/.claude/projects/아래에 저장되어 있습니다.
실제 공개 세션(258턴)에 돌려보면 이런 식의 리포트가 나옵니다.
Result: WASTE DETECTED
1. requery — Read on .../boot.ts
- turns: turn 50 → re-run at turn 58 (of 258 total)
- state: 그 사이 파일이 전혀 수정되지 않음 — 재읽기 결과가 완전히 동일
- 200턴 동안 계속 재소비 (턴당 약 439토큰 → 총 87,800토큰 낭비)
- 예상 비용 영향: $0.026 ~ $0.263
판정 방식은 의외로 심플합니다
Langfuse나 Phoenix처럼 트레이스를 저장·시각화하는 도구가 아닙니다. 이미 끝난 트레이스에서 낭비만 걸러내는 후처리 분석기에 가깝습니다.
판정은 2단계로 이뤄집니다.
- 같은 도구가 같은 인자로 호출된 케이스끼리 묶는다
- 그 출력의
sha256해시가 완전히 같은지 비교한다 — 출력이 다르면 상태가 바뀐 것이므로 낭비로 잡지 않습니다
LLM을 이용한 판정이 아니라 결정론적(deterministic) 로직이라, 같은 트레이스를 넣으면 언제나 같은 결과가 나옵니다. 감지된 낭비는 다시 네 가지로 분류됩니다.
- 에러 반복: 원인을 고치지 않고 같은 에러를 계속 재시도
- 부작용 재실행: 상태를 바꾸는 도구를 같은 인자로 다시 호출
- 회색지대: 읽기 전용 반복 — 부작용은 없지만 토큰은 소모
- 판정불가: Bash, PowerShell처럼 인자 내용에 따라 효과가 천차만별인 도구는 이름만으로 함부로 판정하지 않습니다
실제 벤치마크 데이터로 검증해보니
Toolathlon 벤치마크(프론티어 모델 22종 × 3회 실행, 트레이스 6,780개, tool span 176,270개)에 그대로 돌려본 결과는 흥미로웠습니다.
- 단순 중복 호출은 8,042건이 잡혔지만, 이 중 47%는 회색지대(작업 완료 재선언, 이미 있는 디렉토리 재생성 등)라 걸러내면 4,251건(tool span 대비 2.41%)이 남았습니다.
- 특히 눈에 띈 건 상태를 바꾸는 도구의 중복 실행 1,343건, 그중 같은 인자로 이메일을 두 번 보낸 패턴이 459건이나 됐습니다. 다만 이건 "같은 도구가 같은 인자로 두 번 호출됐다"는 탐지일 뿐, 실제로 메일이 두 번 발송됐는지는 트레이스만으로는 확인이 불가능합니다.
의외의 발견: Claude Code는 생각보다 효율적
파일 재읽기, 무의미한 재시도 같은 낭비 후보 패턴을 여섯 가지 측정했는데, 다섯 가지는 Claude Code 실제 세션에서 거의 존재하지 않았습니다. 캐싱과 컨텍스트 유지 덕분에 이미 상당 부분 막혀 있었던 것이죠.
반면 낭비가 두드러진 쪽은 MCP 서버를 여러 개 붙인 환경이었습니다. 도구가 20개뿐인 Claude Code(0.80%)와 523개나 되는 Toolathlon(2.41%) 사이에 3배 가까운 차이가 났습니다. 도구가 많아질수록 중복 호출 리스크도 커진다는 신호로 보입니다.
아직 갈 길은 남았습니다
개발자 스스로도 한계를 솔직하게 밝히고 있습니다.
- 실측 절감 사례는 아직 0건입니다. 탐지와 추정은 가능하지만, 실제로 이 리포트를 보고 뭔가 고쳐서 청구서가 줄었다는 검증된 사례는 없습니다.
- 회색지대 47%는 걸러내지 않고 '분류'만 해서 보여줍니다. 읽기 전용 반복이 진짜 낭비인지는 실행 맥락에 따라 다르기 때문입니다.
- Cursor, Codex는 아직 지원하지 않습니다.
- 검증에 실패한 탐지기는 과감히 폐기했습니다. 예를 들어 파일 재읽기 탐지기는 30건 표본에서 정밀도가 목표치(70%)를 크게 밑돌아(3.3~0%) 제거했고, 사전등록 문서에 예측과 실제 결과를 함께 기록해뒀다고 합니다. 이런 투명한 검증 태도가 신뢰를 더해줍니다.
마무리
에이전트가 늘어날수록, 그리고 MCP 서버 연결이 많아질수록 눈에 보이지 않는 토큰 낭비도 함께 늘어날 가능성이 큽니다. clew-custos는 아직 초기 단계의 작은 도구지만, "낭비를 있는 그대로 드러내고 과장하지 않는다"는 태도가 인상적입니다. 직접 세션 파일을 갖고 있다면 한 번 돌려보고 결과를 비교해보는 것도 재미있을 것 같습니다.