GitHub PR 46만 건이 알려준 사실: 개발자들의 문체가 'Claude스러워'지고 있다
요약
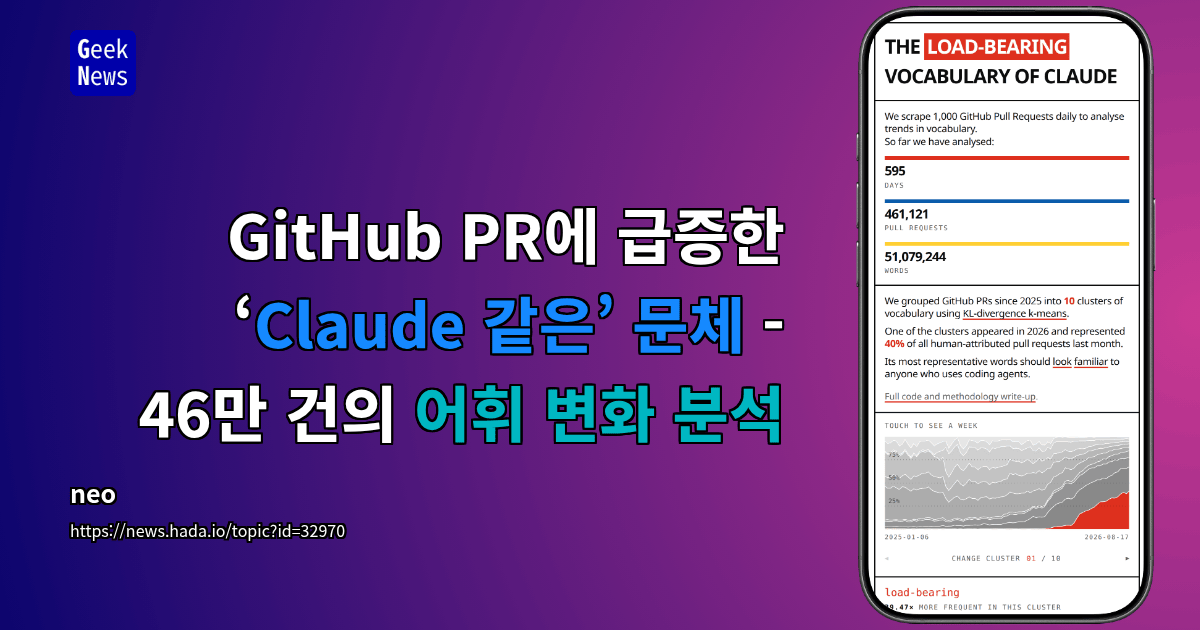
최근 화제가 된 한 분석에 따르면, GitHub의 풀리퀘스트(PR) 설명 문체가 눈에 띄게 바뀌고 있습니다. 2025년 초에는 전체 PR의 0.7%에 불과했던 특정 문체 집단이 2026년 중반에는 무려 **39%**까지 늘었고, 최근 한 달로 좁히면 사람 계정이 작성한 PR의 **약 40%**가 이 문체를 공유하고 있다고 합니다. 이 문체의 핵심 단어는 바로 load-bearing. 최근 코딩 에이전트(특히 Claude)를 자주 쓰는 개발자라면 어딘가 익숙하게 느껴질 표현이죠.
46만 건이 넘는 PR 설명을 분석한 이 프로젝트는 "Claude의 말버릇을 추적하는 것이 아니다"라고 선을 그으면서도, AI가 우리의 글쓰기 방식 자체를 서서히 바꾸고 있을 가능성을 보여주는 흥미로운 데이터를 제시합니다.
무엇을 발견했나
연구자는 2025년 1월부터 GitHub PR 설명을 수집해, 사용된 단어의 분포만으로 10개의 문체 집단으로 자동 분류했습니다. 특정 표현을 미리 지정하거나 Claude가 쓴 문장을 학습시키지 않았다는 점이 핵심입니다. 순수하게 통계적으로 묶었더니 그중 한 집단만 폭발적으로 커진 겁니다.
- 2025년 초: 전체의 약 0.7%
- 2026년 중반: 약 39%
- 최근 한 달(사람 계정 기준): 약 40%
- 최근 12주간 매주 평균 1.2%포인트씩 꾸준히 증가
여기서 '사람이 작성자로 표시된 PR'이라는 표현에 주의할 필요가 있습니다. 봇 계정만 제외했을 뿐, 사람이 직접 타이핑했다는 뜻은 아닙니다. 개인 계정으로 Claude Code 같은 에이전트를 돌려 PR을 올린 경우도 얼마든지 섞여 있을 수 있습니다.
대표 단어 load-bearing, 그리고 친구들
이 문체 집단을 가장 잘 상징하는 단어는 load-bearing(구조적으로 핵심이 되는)이었습니다.
- 전체 데이터에서 1,011회 등장, 905개 PR 설명, 848개의 서로 다른 계정에서 사용
- 이 중 929회가 새로 떠오른 문체 집단 안에서 발견됨
- 집단별 단어 수 차이를 보정해도, 나머지 집단보다 39.47배 더 자주 등장
load-bearing 혼자만 튄 게 아닙니다. 함께 몰려다니는 단어들의 조합이 더 흥미롭습니다.
- 태도를 나타내는 부사:
plainly,quietly,genuinely,deliberately - 구조/설계 비유:
seam,chokepoint,backstop,blast-radius - 무결성 검증 표현:
byte-identical,bit-for-bit,byte-stable - 검증 절차 표현:
mutation-checked,re-verified,cross-checked - 장애 대응 서사:
root-caused,self-heals,fail-loud,fail-soft - 결과 단정 표현:
survived,refuses,proved,falsified
단순한 기술 용어 나열이라기보다, 코드의 의도와 검증 결과를 마치 이야기하듯 단정적으로 설명하는 톤이 한 세트로 묶여 있다는 점이 눈에 띕니다. 실제로 코딩 에이전트와 대화하다 보면 이런 표현을 자주 접하게 되는데, 그게 이제 사람의 PR 설명에도 스며들고 있는 셈입니다.
어떻게 분석했을까 (조사 방법)
신뢰성을 위해 짚고 넘어갈 부분입니다.
- GitHub Search API에서 하루를 2.4시간씩 10개 구간으로 나누고, 각 구간에서 무작위 5분을 골라 표본 조사
- 시간대별 최대 100개, 하루 약 1,000개의 PR 설명을 GitHub Actions로 매일 수집
- 현재까지 85주(595일) 동안 PR 설명 461,121개, 단어 약 5,108만 개를 축적
노이즈를 줄이기 위한 장치도 마련했습니다.
[bot],-bot으로 끝나는 계정이나 Copilot, Dependabot, Renovate, GitHub Actions 계열 앱 제외- 같은 주에 단어 구성이 완전히 같은 중복 PR 설명 제거
- 한 계정이 한 주에 기여할 수 있는 설명을 최대 3개로 제한 (특정 계정의 대량 생성 텍스트가 결과를 왜곡하지 않도록)
- 최소 50개의 서로 다른 계정이 사용한 단어만 분석 대상에 포함 (소수 계정의 프로젝트 전용 용어를 대표 어휘로 오판하지 않도록)
- 이렇게 정제한 데이터를 KL-divergence 기반 k-means로 10개 집단에 배정
이 결과가 '증명하지 않는' 것
제작자 스스로도 HN(해커뉴스)에서 확실히 선을 그었습니다. 이건 "Claude의 말버릇을 추적하는 도구가 아니다"라고요. Claude 사용 여부가 표시된 정답 데이터가 없기 때문에, 다음은 여전히 알 수 없습니다.
- 어떤 PR을 실제로 Claude가 작성했는지
- Claude와 다른 코딩 에이전트 중 어느 쪽의 영향인지
- 사람이 에이전트의 표현을 흡수해서 직접 쓴 것인지
- 문체 변화의 원인이 정말 AI 사용 때문인지
즉, "최근 PR의 40%를 Claude가 작성했다"는 통계가 아니라, "최근 PR의 약 40%가 Claude 사용자에게 익숙한 어휘 분포를 공유하고 있다"는 관찰로 읽는 게 정확합니다.
커뮤니티 반응
HN에서는 다양한 해석이 오갔습니다.
- 많은 사용자가
load-bearing과seam을 Claude가 코드/문서를 설명할 때 유독 반복하는 표현으로 이미 체감하고 있었다고 언급 - 다만
seam은 LLM 이전부터 리팩터링·소프트웨어 공학 문헌에서 쓰이던 용어라는 반박도 나옴 — 즉 개별 단어 하나보다는, 여러 표현이 세트로 함께 급증했다는 '패턴'이 더 의미 있는 신호라는 것 unit-tested,re-verified,provably같은 단어는 Claude만의 고유 어휘라기보다, 에이전트가 자신의 작업을 정당화하고 검증 결과를 보고하도록 훈련받은 결과일 수 있다는 분석도 제기됨- 더 나아가, 사람도 LLM과 대화하며 표현 방식과 문장 구조를 은연중에 학습하기 때문에, 앞으로는 AI가 사람의 글을 닮아가는 동시에 사람이 AI의 문체를 받아들이는 '순환'이 심화될 수 있다는 흥미로운 전망도 나왔습니다.
정리하며
이 분석이 "Claude가 PR의 40%를 썼다"는 증거는 아니지만, AI 코딩 도구가 단순히 코드만 바꾸는 게 아니라 우리가 코드를 '설명하는 방식' 자체에도 스며들고 있다는 정황은 꽤 설득력 있게 다가옵니다. 혹시 여러분의 최근 커밋 메시지나 PR 설명에도 load-bearing, seam, byte-identical 같은 표현이 늘어나지 않았나요? 한 번 되돌아볼 만한 재미있는 데이터입니다.