월 400달러 구독을 끊었다: M4 Pro Mac mini 한 대로 만든 상시 로컬 LLM 서버
한눈에 보는 요약
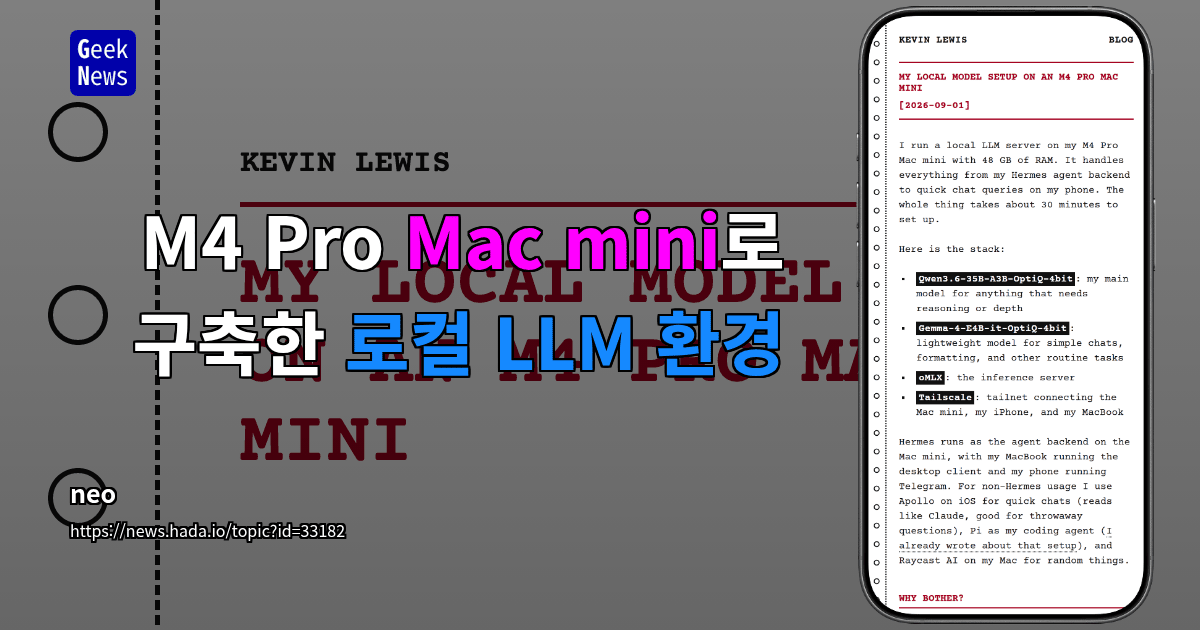
48GB RAM을 탑재한 M4 Pro Mac mini를 24시간 켜두는 LLM 서버로 만든 사례입니다. 셋업에 걸린 시간은 약 30분. 추론과 에이전트 작업은 Qwen3.6-35B-A3B, 가벼운 대화는 Gemma-4-E4B가 맡습니다.
핵심만 먼저 정리하면 이렇습니다.
- 비용: 토큰당 과금이 사라지고 하드웨어 구매비 + 전기료로 수렴
- 성능: Qwen 4비트 모델 기준 프롬프트 처리 325 tok/s, 토큰 생성 34 tok/s
- 메모리: Qwen은 약 20GB, Gemma는 약 2.4GB
- 커버리지: GPT-5나 Claude Opus급이 필요 없는 일상 요청의 **약 80%**를 로컬이 처리
중요한 건 목표가 "API 모델의 완전한 대체"가 아니라는 점입니다. 무거운 작업은 여전히 클라우드에 맡기고, 나머지를 로컬로 흡수하는 하이브리드 전략입니다.
왜 클라우드가 아니라 로컬인가
필자가 든 이유는 감성적인 "자급자족" 취향이 아니라 꽤 실무적입니다.
통제권의 문제
- 클라우드 API는 결국 임대 환경입니다. 공급자가 가격, 사용량 한도, 실제로 서빙되는 모델을 언제든 바꿀 수 있습니다.
- 실제로 월 200달러짜리 구독 두 개의 한도를 정기적으로 소진했다고 합니다.
- 같은 모델 이름인데도 시점에 따라 성능이 달라지거나, 공지 없이 품질이 내려간 경험도 있었고요.
보안과 되돌릴 수 없는 결정
외부 API로 보낸 데이터가 어떻게 이용되고 노출될지는 알기 어렵습니다. 민감한 코드, 고객 데이터, 독점 워크플로를 한 번 전송하고 나면 사후에 되돌릴 방법이 없다는 지적은 특히 새겨둘 만합니다. 여기에 규제 리스크도 있습니다. 정부가 특정 모델 배포를 제한하면, 그 모델에 의존하던 워크플로는 그날로 멈춥니다.
그리고 실용적인 이점들
| 항목 | 로컬 운영의 효과 | | --- | --- | | 비용 예측 | 추론별 추가 비용 없음 | | 지연 시간 | 네트워크 왕복이 없어 일상 요청이 빠름 | | 오프라인 | 인터넷 없이도 백그라운드 에이전트 실행 | | 사용량 제한 | 공급자 임계치·정책의 영향 없음 |
구성: 서버 한 대, 클라이언트 여럿
Mac mini 한 대가 로컬 LLM 서버와 Hermes 에이전트 백엔드를 함께 돌리고, 나머지 기기는 전부 클라이언트입니다.
- 추론 서버: oMLX (8000번 포트에서 수신)
- 네트워크: Tailscale로 Mac mini·MacBook·iPhone을 하나의 사설 메시 네트워크로 연결
- 클라이언트
- MacBook의 Hermes 데스크톱 앱, iPhone의 Telegram → Hermes 접근
- iOS의 Apollo → 문단 재작성, 오류 메시지 해석 같은 일회성 질문
- Mac의 Raycast AI → 별도 도구 설치 없이 처리할 임시 작업
- Pi → 코딩 에이전트
여기서 Tailscale의 역할이 생각보다 큽니다. 서비스를 공용 인터넷에 전혀 노출하지 않으면서 모든 클라이언트가 동일한 엔드포인트(http://[mac-mini-tailnet-url]/v1)를 바라보게 만듭니다. 기기마다 설정이 조금씩 달라지는 구성 드리프트를 원천 차단하는 셈이죠.
Hermes 데스크톱 앱은 그 자체가 모델을 돌리는 게 아니라 다른 장치의 백엔드에 접속하는 셸(shell) 역할입니다. 덕분에 MacBook에서 보던 대화 기록을 Telegram에서 그대로 이어갈 수 있습니다.
모델 이름 읽는 법 (여기가 핵심입니다)
로컬 LLM에 처음 발을 들이면 모델 이름이 암호처럼 보입니다. 하나씩 뜯어봅시다.
Qwen3.6-35B-A3B-OptiQ-4bit
Qwen3.6— 모델 계열과 버전35B— 모든 전문가(expert)를 합친 전체 매개변수 수A3B— 토큰당 활성화되는 매개변수는 35B가 아니라 3BOptiQ-4bit— 대부분 4비트, 민감한 계층만 8비트를 쓰는 혼합 정밀도 양자화
Gemma-4-E4B-it-4bit
gemma-4— Google Gemma 4 계열e4b— 약 40억 개 전체 매개변수에 해당하는 인코딩 크기it— 명령어 튜닝(instruction-tuned) 모델4bit— 균일한 4비트 양자화
밀집형(Dense) vs MoE, 무엇이 다른가
이 차이를 이해하면 "내 기기에서 돌아갈까?"에 스스로 답할 수 있습니다.
- 밀집형 27B: 토큰 하나를 처리할 때마다 270억 개 매개변수를 전부 메모리에 올려 계산합니다.
- MoE인 Qwen3.6-35B-A3B: 350억 개가 256개 전문가에 분산되어 있고, 토큰마다 약 30억 개만 활성화됩니다. 나머지 320억 개도 통합 메모리에 존재는 하지만 그 토큰 계산에는 참여하지 않습니다.
실제 메모리 배분은 이렇습니다.
- 48GB Mac mini에서 Qwen 4비트 = 약 20GB
- 남은 28GB는 컨텍스트 창 + 운영체제 + 기타 프로세스 몫
- Gemma-4-E4B는 약 2.4GB — 간단한 작업에 20GB 모델을 깨우는 낭비를 막아줍니다
💡 흥미로운 지점: 16GB MacBook Air에서는 4비트 밀집형 27B 모델이 약 14GB를 요구해 OS 공간이 남지 않고, SSD 스왑이 시작되면 속도가 급락합니다. 반면 Qwen MoE는 활성 메모리 부담이 밀집형 6B 수준이라 같은 MacBook에서도 실행할 수 있습니다. 다만 전체 35B 가중치는 여전히 통합 메모리에 올라가 있어야 합니다.
내 하드웨어에서 돌아갈까? 체크리스트
- 양자화 파일 크기부터 확인합니다. 4비트 모델은 대략 매개변수 수의 절반에 해당하는 GB가 필요합니다. 35B 모델이라면 양자화 방식에 따라 약 17~20GB.
- macOS 몫을 뺍니다. Apple Silicon에서 약 6~8GB.
- 컨텍스트 창과 KV 캐시 공간을 남깁니다. 수천 토큰마다 수 MB가 쌓이므로, 긴 대화를 예상한다면 8~16GB를 따로 계획하세요.
- MoE라면 전체 매개변수와 토큰당 활성 매개변수를 둘 다 봅니다.
- 10~15% 여유를 남깁니다. 모델 + 컨텍스트 합계가 가용 통합 메모리 한계에 붙으면 SSD 스왑이 발생합니다.
M4 Pro의 실제 속도
Qwen 기준 평균 프롬프트 처리 325 tok/s, 토큰 생성 34 tok/s입니다.
여기서 갈리는 변수는 메모리 대역폭인데, 대역폭은 "실행 가능 여부"보다 "얼마나 빠른가"를 결정합니다.
| 칩 | 통합 메모리 대역폭 | | --- | --- | | M3 (기본) | 100GB/s | | M2 Pro | 200GB/s | | M4 Pro | 273GB/s | | M3 Max | 최대 400GB/s |
M4 Pro는 Pro와 Max 사이에 위치합니다. 토큰이 즉각 쏟아지는 수준은 아니지만, 실사용에는 충분하다는 평가입니다.
모델 교체는 몇 분이면 끝
로컬 환경의 진짜 매력은 여기 있습니다. 새 모델이 나올 때마다 이렇게만 하면 됩니다.
- 새 모델을
~/models/에 다운로드 - oMLX가 모델 디렉터리에서 자동 발견
- oMLX 앱에서 선택하거나 서버 재시작
- Hermes, Pi, Raycast, Apollo에서 사용할 모델 변경
oMLX 관리 대시보드에는 HuggingFace 탐색기와 다운로드 기능이 내장되어 있고, CLI도 지원해서 다른 기기에서 SSH로 접속해 관리할 수도 있습니다.
양자화로 인한 품질 손실은? OptiQ 4비트를 적용한 35B-A3B는 BF16 대비 대부분 벤치마크에서 약 1~2점 낮은 수준입니다. 메모리 사용량을 약 70GB에서 48GB 이내로 끌어내린 대가치고는 받아들일 만합니다.
에이전트 작업을 살리는 KV 캐시 지속성
oMLX의 KV 캐시 지속성은 에이전트 워크플로에서 특히 빛을 발합니다.
- 각 블록을 SSD에 캐시해 둡니다
- 코딩 에이전트가 이전 컨텍스트 접두부로 되돌아가면, 재계산 없이 수 ms 만에 디스크에서 복원합니다
과거 컨텍스트를 반복적으로 참조하는 Hermes 같은 워크플로를 로컬에서 실용적으로 돌릴 수 있게 만드는 결정적 요소입니다.
정리하며
Apple Silicon의 로컬 모델은 이제 "취미로 만져보는 것" 단계를 넘어섰습니다. 대부분의 일상 작업을 감당할 만큼 품질이 올라왔고, M4 Pro Mac mini 정도에서도 안정적으로 돌아갑니다.
- 토큰별 비용이 없습니다
- 민감한 데이터가 제3자 엔드포인트로 나가지 않습니다
- 새 모델 실험 비용이 "저장 공간 + 짧은 교체 작업"으로 끝납니다
다른 Apple Silicon 기기에도 같은 구성을 적용할 수 있지만, 메모리 사양에 맞춰 모델은 바꿔야 합니다. 참고로 필자는 현재 M4 Pro에 만족하면서도, 연내 배송 예정인 128GB M5 Max Mac Studio를 이미 주문해 둔 상태라고 합니다. 로컬 LLM의 다음 체급이 어디까지 갈지 궁금해지는 대목입니다.
출처: GeekNews - 개발/기술/스타트업 뉴스 서비스