DeepSeek V4.1 Flash 공개: 이름은 '가장 작은 모델', 실체는 552B
한 줄 요약
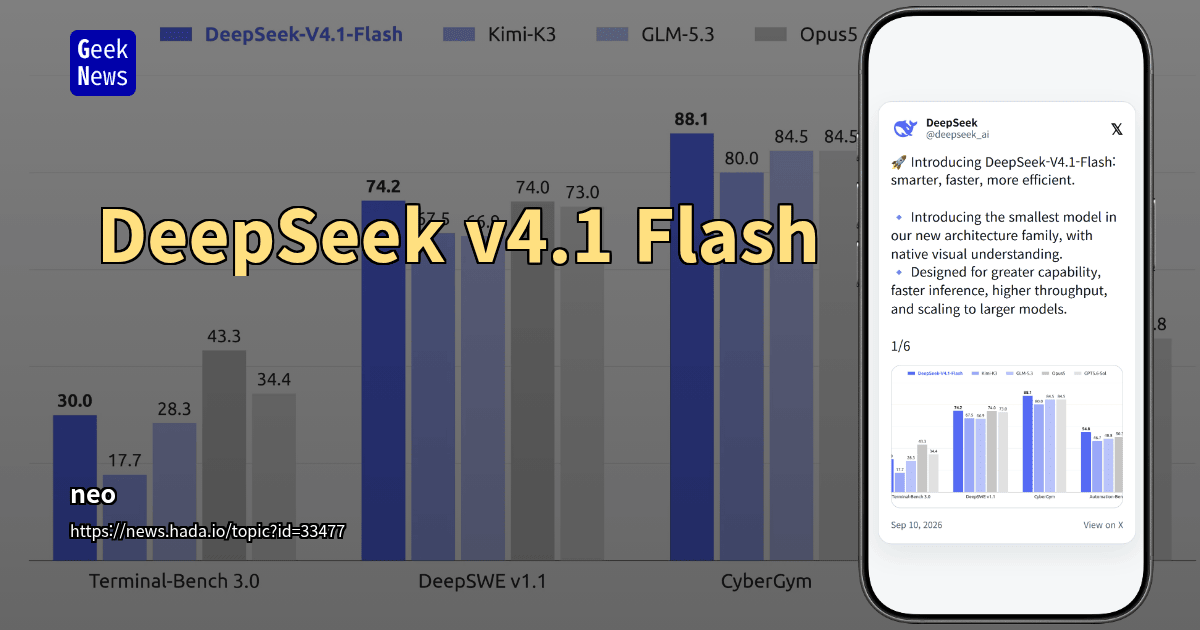
DeepSeek가 새로운 아키텍처 계열의 가장 작은 모델로 DeepSeek-V4.1-Flash를 공개했습니다. 네이티브 시각 이해를 지원하고, 추론 속도와 처리량을 동시에 끌어올리는 것을 설계 목표로 삼았습니다. 다만 '가장 작은'이라는 수식어와 달리, 실제 몸집은 이전 세대의 두 배 가까이 커졌습니다.
무엇이 달라졌나
DeepSeek가 공식적으로 강조한 방향성은 세 가지입니다.
- 네이티브 시각 이해 지원 — Flash 계열에서 멀티모달 입력을 정식으로 다루기 시작했습니다
- 추론 속도 + 처리량 — 단순히 빠른 응답이 아니라, 전체 스루풋 개선까지 함께 겨냥했습니다
- 확장 가능한 아키텍처 — 이번 구조는 처음부터 더 큰 모델로 스케일업하는 것을 염두에 두고 설계됐습니다
마지막 항목이 특히 의미심장합니다. Flash는 새 아키텍처의 첫 타자일 뿐, 상위 모델이 뒤따를 것이라는 신호로 읽히기 때문입니다.
숫자로 보는 구조
모델은 이미 Hugging Face에 올라와 있고, 커뮤니티가 정리한 구성은 다음과 같습니다.
| 항목 | 수치 | | --- | --- | | 본체 파라미터 | 552B (이전 V4 Flash는 284B) | | 활성 파라미터 | 프리필 8B / 디코딩 16B | | Engram 메모리 | 별도 196B (SSD 배치 가능) | | 전역 KV 캐시 | 토큰당 890바이트 |
눈여겨볼 지점은 KV 캐시입니다. 토큰당 890바이트는 이전 V4 Flash의 약 4분의 1 수준으로, 긴 컨텍스트를 다룰 때 메모리 부담을 크게 덜어주는 설계입니다. 활성 파라미터도 기존의 고정 13B에서 8B/16B 구조로 바뀌어, "Flash"라는 이름이 총 크기가 아니라 토큰당 연산량 기준이라는 해석이 나옵니다.
로컬 실행: 문턱이 확 올라갔다
로컬 구동을 노리던 사용자에게는 다소 아쉬운 소식입니다.
- 이전 Flash는 대부분 FP4로 배포돼 약 160GB였지만, 이번에는 FP8 기준 약 510GB
- 커뮤니티 계산으로는 256GB 메모리로 4비트 양자화 모델조차 빠듯하다는 평가
- KV 캐시 공간까지 감안하면, 일반 소비자용 보드보다는 쿼드 채널 구성(Threadripper급 이상)이 필요
다만 Engram 메모리 196B는 SSD에 둘 수 있는 구조여서, 제삼자 양자화가 나오면 체감 요구 사양은 달라질 수 있습니다. "효율성 개선은 반갑지만, 이제는 Flash보다 더 가벼운 버전이 필요하다"는 반응이 나오는 이유입니다.
가격은 올랐습니다
출력 기준 100만 토큰당 0.16달러 → 1.20달러로 인상됐습니다. 성능 향상폭을 감안하면 납득할 만하다는 평가와, 저렴함이 최대 무기였던 Flash의 정체성이 흔들린다는 평가가 엇갈립니다. 참고로 V4 Pro는 서비스 종료가 예고된 상태여서, 앞으로는 Flash 계열이 주력이 될 가능성이 높습니다.
커뮤니티 반응
긍정적인 쪽
- 기술 보고서가 실질적인 세부 사항으로 가득해 연구자들에게 호평
- 출시할 때마다 새로운 아키텍처 아이디어를 실제 프로덕션 모델에 투입하는 과감함
- 첫인상 기준으로 성능이 강력하고, 지시를 그대로 수행하려는 성향이 강하다는 평
- 야간 배치 작업(중복 제거된 오류 로그 기반 버그 자동 분류) 같은 반복 업무에 잘 맞는다는 실사용 후기
아쉬운 쪽
- 웹 채팅과 모바일 앱에서 영어로 물어도 중국어로 답하는 사례가 잦음 (API에서는 거의 발생하지 않는다는 증언)
- 벤치마크 점수 상승이 순수 성능 향상인지, 200B 규모의 Engram이 추가된 효과인지 아직 판단 이르다는 지적
- 중국 모델 관련 글이 지나친 찬양으로 흐른다는 메타 비판도 함께 제기됨
정리하며
DeepSeek V4.1 Flash는 "작고 빠른 모델"이라기보다 토큰당 연산량을 억제한 대형 모델에 가깝습니다. KV 캐시 압축과 Engram 메모리라는 새 설계 요소를 실전에 투입했다는 점에서 아키텍처 실험의 의미가 크고, 이 구조를 그대로 확장한 상위 모델(V4.1 Pro 등)이 이어질 것이라는 기대도 자연스럽게 따라옵니다.
로컬 구동을 계획 중이라면 양자화 버전이 나올 때까지 기다리는 편이 현실적이고, API로 쓸 생각이라면 인상된 가격과 언어 혼입 이슈를 먼저 체크해 보시길 권합니다.