스왑 한 번에 40ms 멈춤: Go GC가 디스크를 기다릴 때 생기는 일
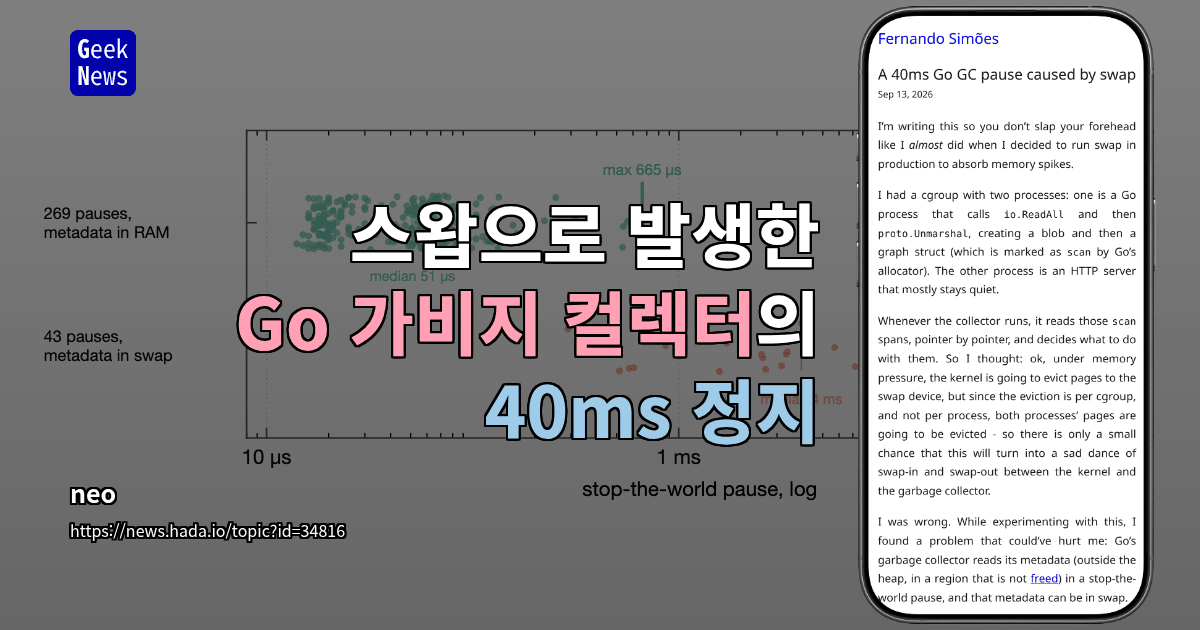
한눈에 보는 핵심
- Go GC는 STW(Stop-The-World) 구간에서 힙 바깥에 있는 메타데이터를 읽습니다. 이 메타데이터도 스왑으로 밀려날 수 있고, 다시 읽어오는 동안 최대 40ms의 정지가 발생했습니다.
- 커널 6.8 + MGLRU 환경(Hetzner)에서 STW 정지의 중앙값은 약 51µs였지만, 최악의 사례는 39,902µs(약 40ms) — 중앙값의 약 800배였습니다.
- 그 40ms 중 39ms가 페이지 폴트 처리에 소모됐고, 폴트는 228회 발생했습니다.
- STW 중에는 모든 P가 멈추므로, I/O가 끝난 고루틴조차 그 결과를 처리할 수 없습니다.
- 별개로, 511KiB 메시지 하나를 만드는 시간이 평소 3~5ms에서 NVMe 105ms, 네트워크 볼륨 903ms까지 늘어나는 현상도 관측됐습니다(원인 미확인).
어쩌다 이런 실험을 하게 됐나
출발점은 꽤 현실적인 고민이었습니다. 메모리 사용량이 순간적으로 치솟는 상황을 흡수하기 위해 프로덕션에 스왑을 쓰는 게 어떨까를 검토한 것이죠. 구성은 하나의 cgroup 안에 두 프로세스를 두는 형태였습니다.
- Go 프로세스:
io.ReadAll로 바이트를 읽고 이어서proto.Unmarshal을 호출해 그래프 구조체를 만듭니다. 이 구조체는 Go 할당기에서scan대상으로 표시됩니다. - 다른 프로세스: 대부분 유휴 상태인 HTTP 서버.
GC는 scan 스팬을 포인터 단위로 훑습니다. 페이지 퇴거가 프로세스 단위가 아니라 cgroup 단위로 일어나니, 두 프로세스의 페이지가 함께 밀려나면서 커널과 GC가 서로 스왑 I/O를 주고받는 최악의 시나리오는 잘 안 생기겠지, 라고 예상했습니다. 실험 결과는 그 예상과 달랐습니다.
스왑된 GC 메타데이터가 전체 실행을 멈추는 경로
문제의 본질은 "GC가 보는 데이터"가 힙에만 있는 게 아니라는 점입니다.
- 런타임이 할당한 메타데이터 페이지는 GC 주기마다 읽힙니다. 이 영역은 해제되지 않고 재사용되지만, 그렇다고 스왑 대상에서 빠지는 건 아닙니다.
- 커널은 페이지의 최근 접근 시점을 기준으로 오래 손대지 않은 페이지를 스왑으로 내보냅니다.
- 이후 GC가 전체 실행을 멈춘 상태에서 그 페이지를 읽으면 메이저 페이지 폴트가 터집니다.
- 페이지를 되돌리려면 커널의 스왑 처리와 디스크 대기를 전부 거쳐야 합니다.
- PTE 읽기 →
do_swap_page호출 → 새 프레임 확보 → cgroup에 메모리 사용량 부과 - 페이지 읽기 → bio 제출 → 디스크 대기 → 메모리 복귀
- PTE 읽기 →
여기서 타이밍이 특히 고약합니다. Go GC는 스윕 종료(sweep termination) 와 마킹 종료(mark termination) 두 지점에서 전체 실행을 정지하는데, 바로 그 구간에서 디스크를 기다리게 되는 것이죠. 모든 P가 멈춰 있으니 I/O 완료를 기다리던 고루틴은 완료 통지가 와도 손을 쓸 수 없습니다. 정지가 끝날 때까지 전부 대기입니다.
실제로 측정해 보니
커널 6.8, MGLRU가 켜진 Hetzner 서버에서 모의 실험을 진행했습니다.
| 항목 | 값 | | --- | --- | | 관측 시간 | 30분 | | STW 정지 횟수 | 312회 | | 정지 시간 중앙값 | 약 51µs | | 최악의 정지(NVMe 스왑) | 약 40ms (중앙값의 ~800배) |
이 정도 지연은 메모리 급증 한 번당 두세 차례 나타났습니다. BPF 스크립트로 STW 구간의 페이지 폴트를 집계한 최악의 사례는 다음과 같습니다.
- 전체 정지: 39,902µs
- 페이지 폴트: 228회
- 폴트 처리 시간: 39,013µs
즉 40ms 중 39ms가 순수하게 페이지 폴트 처리였습니다. 호출 스택도 원인을 분명하게 가리켰습니다.
runtime.(*spanSet).reset
runtime.nextMarkBitArenaEpoch
runtime.finishsweep_m
runtime.gcStart.func2
runtime.systemstack
runtime.gcStart
애플리케이션 코드가 아니라 GC 내부 관리 작업이 디스크를 기다리고 있었던 셈입니다.
설명되지 않은 또 하나의 비용
메타데이터 정지와는 별개로, 511KiB 메시지 하나를 생성하는 시간이 이렇게 변했습니다.
- 평소: 3~5ms
- NVMe 스왑 사용 시: 105ms
- Hetzner 네트워크 볼륨 사용 시: 903ms
메시지당 지연 폭은 메타데이터 정지보다 훨씬 큽니다. 다만 성격이 다릅니다. 이 지연은 할당을 수행하는 고루틴에만 국한되고, 전체 실행을 멈추지는 않습니다. 그리고 이 시간이 정확히 어디에서 소모되는지는 확인되지 않았습니다. 추측을 사실처럼 적지 않은 점이 오히려 이 실험 기록의 미덕입니다.
그래서 스왑이 나쁜 걸까?
원문 저자는 "스왑 자체가 나쁜 것은 아니다"라는 입장에서 Chris Down의 스왑 옹호 글과 생각을 같이합니다. 결론은 좀 더 좁고 구체적입니다.
이번 실험 환경에서는 스왑과 Go GC의 조합이 잘 작동하지 않았고, 대상 프로덕션 환경에서는 GC가 자주 실행된다.
GC 주기가 짧을수록 메타데이터를 다시 만지는 빈도가 높아지고, 그만큼 스왑된 페이지를 STW 중에 되돌릴 확률도 올라갑니다. 레이턴시에 민감한 Go 서비스라면 "메모리 급증 대비"라는 이점과 "40ms 정지"라는 비용을 함께 저울에 올려야 합니다.
새 GC가 해결해 줄 거라는 기대도 일단은 접어 두는 게 좋겠습니다. 9월 14일 추가 측정에서 Go 1.26의 Green Tea GC가 이 메타데이터 읽기 문제에 미치는 영향은 미미했다고 보고됐습니다. 메타데이터가 스왑 대상이 될 수 있다는 구조 자체는 그대로이기 때문입니다.
직접 재현해 보고 싶다면
저자는 go-gc-swap-cost에 실험 자료를 공개했습니다.
- 측정 그래프
- 모의 할당기
- BPF 스크립트
- Python 스크립트
정리
- Go GC의 STW 정지는 보통 마이크로초 단위지만, 메타데이터가 스왑되면 밀리초 단위로 튑니다.
- 원인은 GC 로직이 느려서가 아니라, STW 구간에 디스크 대기가 끼어들기 때문입니다.
- cgroup 단위 퇴거, MGLRU 같은 커널 측 메커니즘도 이 조합을 막아 주지는 않았습니다.
- 스왑 도입을 검토 중이라면, 평균값이 아니라 테일 레이턴시를 보고 판단하세요. 중앙값 51µs는 아무 문제가 없어 보이지만, 같은 시스템에서 40ms 정지가 메모리 급증마다 두세 번씩 발생했습니다.