"그래서 내 상황엔 무슨 AI 모델을 써야 해?" 구독·종량제별 가성비 모델 추천 서비스 'AI 뭐쓰지?'
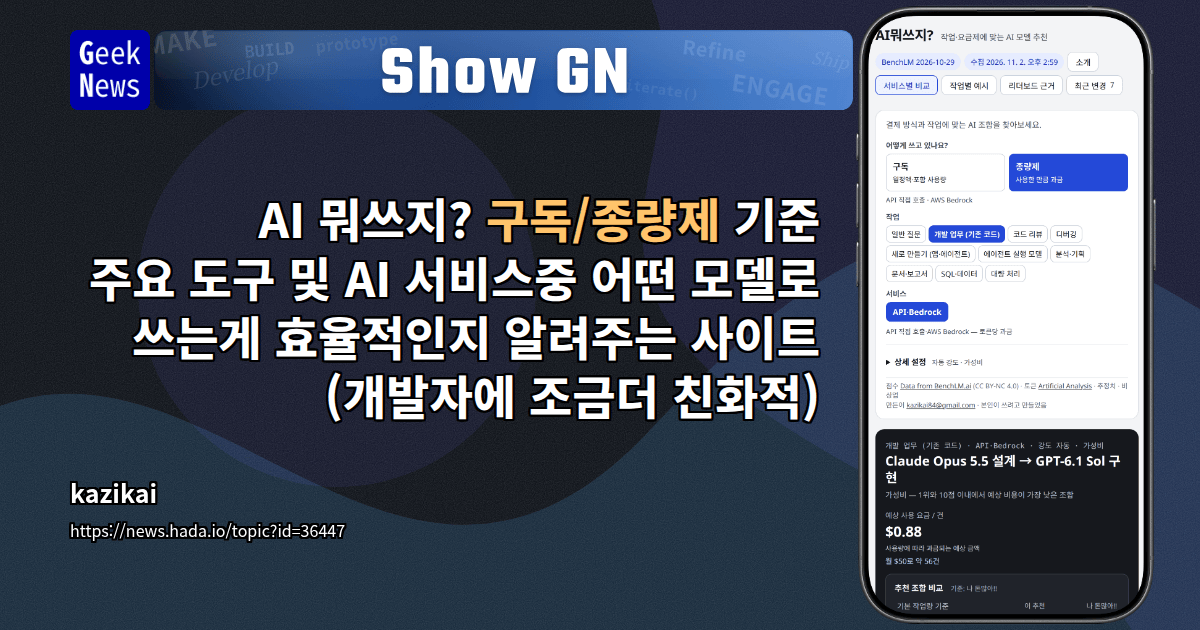
들어가며
LLM 리더보드는 매주 바뀌고, 토큰 가격표는 갈수록 복잡해지고 있습니다. 그런데 정작 개발자가 알고 싶은 건 "Cursor Pro를 쓰고 있는데, 디버깅할 때는 어떤 모델을 어느 정도 추론 강도로 돌려야 하지?" 같은 내 상황에 맞는 답이죠.
GeekNews의 Show GN에 이 질문에 답해 주는 개인 프로젝트 **'AI 뭐쓰지?'**가 올라왔습니다. 만든 분은 "매일 벤치마크나 SNS 트렌드를 챙겨볼 수는 없어서, 순전히 개인적인 필요로 만들었다"고 소개했어요. 목표는 단순합니다. AI 모델을 가성비 있게 쓰는 것.
핵심 요약
- 무엇을 하나요? 사용 중인 도구(Cursor, GitHub Copilot, Claude 구독, API 등)와 결제 방식에 맞춰 작업별로 효율적인 모델과 추론 강도를 추천합니다.
- 데이터는 어디서 오나요? BenchLM, Artificial Analysis, LiteLLM, OpenRouter, 공식 문서에서 12시간마다 자동으로 수집합니다.
- 어떤 점이 좋나요? 모델이나 추론 강도를 바꿨을 때 점수와 비용이 얼마나 달라지는지 직접 시뮬레이션해 볼 수 있습니다.
- 주의할 점은? 일부 수치는 추정치이고, 구독 서비스의 실제 잔여 한도는 반영하지 못합니다.
주요 기능 살펴보기
1. 결제 방식·서비스·요금제별 맞춤 필터링
구독제인지 종량제(API)인지, 어떤 서비스의 어떤 요금제를 쓰는지에 따라 선택지를 좁혀 줍니다. 같은 모델이라도 어떤 도구에서 쓰느냐에 따라 비용 구조가 완전히 달라지니, 출발점으로 꼭 필요한 기능입니다.
2. 10가지 실무 작업별 추천
코딩, 디버깅, 문서 작성 등 실무 작업 10가지로 나눠 추천합니다. 제작자가 실제로 자주 하는 업무를 기준으로 분류했다고 하니, 현업 개발자라면 공감할 만한 구성일 거예요.
3. 우선순위별 최적 조합 3가지
- 💡 가성비: 메인으로 추천하는 기준
- 💸 나 돈많아!!: 비용보다 성능이 우선일 때
- 🪙 제일 싸게: 최소 비용이 목표일 때
선택지를 일부러 세 가지로 줄였다고 합니다. 상황을 너무 잘게 나누면 오히려 헷갈리기 때문이죠. 제작자의 말을 빌리면 *"토큰 부자이신 분들은 그냥 비싼 모델로 계속 돌리시면 된다"*고요. 대신 가성비 있게 써도 실제 결과물에 큰 차이가 없는 현실적인 기준을 잡는 데 신경 썼다고 합니다.
4. 인터랙티브 시뮬레이션
단계별로 모델과 추론 강도(낮음~최대)를 직접 바꿔 볼 수 있습니다. "지금 쓰는 모델을 다른 걸로 바꾸면 벤치마크 점수와 비용이 얼마나 달라질까?"가 궁금해서 넣은 기능이라고 해요. 모델 전환을 고민할 때 특히 쓸모가 많습니다.
5. 12시간 주기 자동 갱신 및 변경 추적
| 데이터 소스 | 수집 항목 | |---|---| | BenchLM | 벤치마크 점수 | | Artificial Analysis | 모델·강도별 실제 토큰 소비량, 지능 지수 | | LiteLLM · OpenRouter · 공식 문서 | 가격, 지원 모델 |
[최근 변경] 탭에서는 신모델 추가, 가격 인하, 구모델 전환 내역을 한눈에 볼 수 있습니다. 모델 업데이트 소식을 일일이 따라가기 벅찼던 분들께 반가운 기능이에요.
알아두면 좋은 한계점
제작자가 한계를 솔직하게 정리해 둔 점도 눈에 띕니다. 추천 결과를 볼 때 함께 염두에 두면 좋겠습니다.
① 작업별 토큰량·재작업률은 '가정이 들어간 추정치'
작업 1건당 기본 입출력 토큰량, 점수 1점당 재시도 증가율(+1.5%), 상위 모델로 설계했을 때의 품질 상승분(격차의 30%), 추론 강도 민감도 등은 임의로 정한 가정값입니다. 프롬프트 습관이나 코드베이스 크기에 따라 실제 비용과 차이가 날 수 있어요.
② 구독제의 '실제 잔여 한도(Quota)'는 계산하지 못함
Claude Pro/Max, ChatGPT Plus 같은 구독 서비스는 메시지 한도나 동적 제한이 공개되어 있지 않습니다. 그래서 **"같은 작업을 표준 API로 돌렸을 때의 환산 비용"**을 참고 지표로 삼아 가성비를 간접 비교합니다.
③ 공개 벤치마크와 실무 체감의 차이
점수는 공개 리더보드(BenchLM) 기준이라, 사내 특수 도메인이나 특정 에이전트 하네스 환경에서의 체감과는 다를 수 있습니다. Artificial Analysis 실측 데이터가 아직 없는 최신·변형 모델은 같은 계열 모델 값으로 추정하거나 기본값으로 대체합니다.
④ 도구별 세부 과금 옵션 미반영
프롬프트 캐싱 할인, Cursor의 Fast/Max 모드, 캐시·지역별 특수 요금, 각 도구의 비공개 기본 추론 강도 등은 반영되지 않고 표준 모드로 단순화해서 계산합니다.
에디터의 한마디
AI 코딩 도구가 일상이 되면서 "어떤 모델이 제일 똑똑한가"보다 **"내 예산과 작업에 어떤 모델이 맞는가"**가 더 실용적인 질문이 됐습니다. 'AI 뭐쓰지?'는 흩어져 있는 벤치마크, 가격, 토큰 소비량 데이터를 한곳에 모아 이 질문에 현실적인 답을 주려는 시도예요.
추정값이 섞여 있는 만큼 결과를 정답으로 받아들이기보다는 모델 선택의 출발점이자 비교 도구로 쓰는 게 좋겠습니다. 매달 AI 구독료나 API 청구서가 신경 쓰였다면 한 번 들러볼 만합니다. 원하는 기능이 있다면 제작자에게 메일로 제안할 수도 있어요.
원문: https://news.hada.io/topic?id=36447&utm_source=geeknews&utm_medium=rss&utm_campaign=news